엔비디아, AI 인프라용 워크로드 맵 공개
최근 30일 조회수 — 좋아요 —핵심 요약
분산 AI 워크로드를 공통 형식으로 정의해 쿠버네티스의 새 프레임워크 지원을 간소화한다.
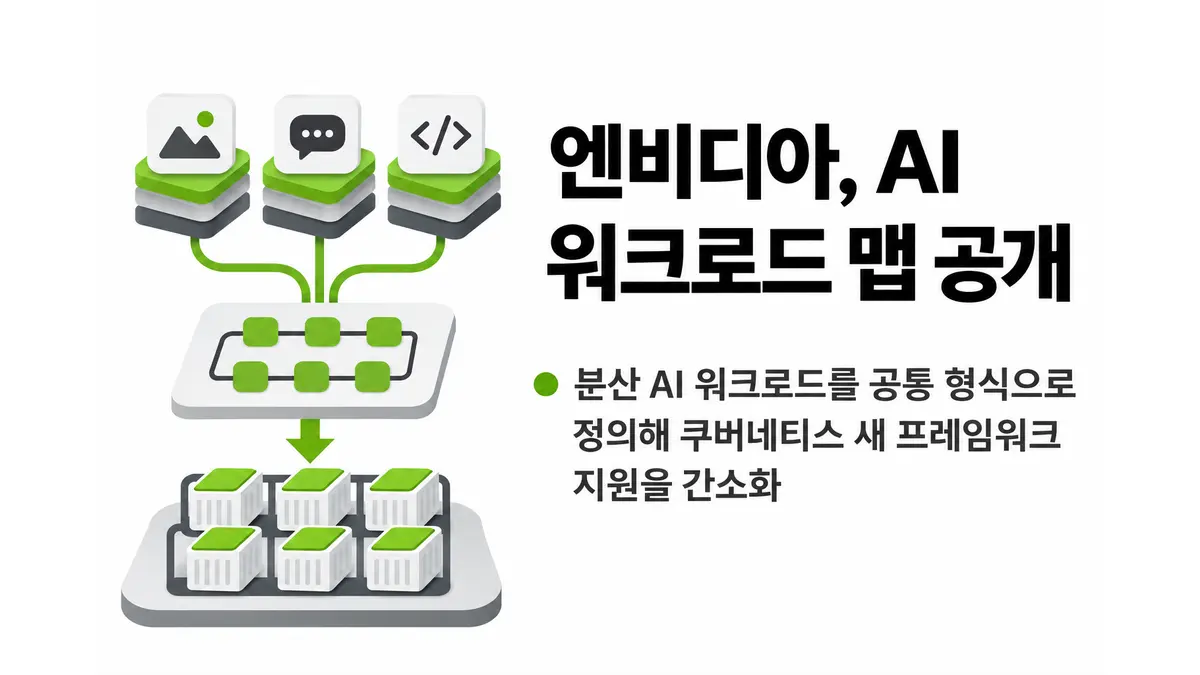
엔비디아(NVIDIA)가 쿠버네티스(Kubernetes) 기반 AI 인프라에서 새 프레임워크 지원에 걸리는 시간을 줄이기 위한 ‘워크로드 맵(Workload Map)’을 공개했다. 엔비디아 DSX AI 팩토리 플랫폼(NVIDIA DSX AI Factory Platform)의 구성 요소로, 서로 다른 프레임워크가 제각각 표현하는 분산 워크로드 구조를 공통 형식으로 기술한다. 스케줄러와 컨트롤러, 관리 플랫폼은 프레임워크별 해석 코드를 따로 만들지 않고 이 정의를 재사용할 수 있다는 것이 엔비디아의 설명이다.1
분산 학습이나 다중 노드 추론 작업은 대개 단일 파드(Pod)가 아니라 여러 자원의 묶음이다. 각 파드 그룹에는 역할과 복제본 수, 파드 템플릿이 있으며, 작업 상태를 판정하는 방식도 워크로드 유형마다 다르다. 특히 JobSet, LeaderWorkerSet 같은 쿠버네티스 사용자 정의 리소스(CRD)는 구조와 상태, 파드 명세 수정법이 서로 달라 별도 어댑터가 필요했다. 엔비디아 Run:ai 팀도 CRD가 추가될 때마다 전용 어댑터를 개발해야 했고, 이 때문에 새 워크로드 지원이 일회성 작업이 아니라 프레임워크별 개발 일정과 제품 출시 주기에 묶였다고 밝혔다.1
워크로드 맵은 이 차이를 코드 대신 재사용 가능한 설명으로 옮긴다. 개발자가 특정 워크로드의 구성 요소와 복제본, 파드 템플릿, 상태 해석법을 한 번 정의하면 여러 도구가 같은 정보를 읽을 수 있다. 엔비디아는 하나의 분산 JobSet 정의를 워크로드 점검, 갱 스케줄링(gang scheduling), 플랫폼 가시성 확보에 함께 쓰는 사례를 제시했다. 갱 스케줄링은 분산 작업에 필요한 파드들을 묶어서 배치하는 방식이다.1
예시 작업은 리더 작업 1개와 워커 작업 2개로 구성되며, 각 작업이 GPU 4개를 요청해 모두 12개가 필요하다. 그러나 일반적인 kubectl 조회에서는 JobSet과 세 개의 잡(Job), 그 아래 파드가 별도 항목으로 표시된다. 이를 하나의 분산 작업으로 이해하려면 기존에는 JobSet 전용 코드가 필요했다. 워크로드 맵의 핵심은 이 해석 규칙을 공통 계층으로 분리하는 데 있다.
다만 엔비디아가 공개한 자료는 설계 방식과 활용 예시를 설명할 뿐, 실제 어댑터 개발 기간이 얼마나 줄어드는지나 지원 프레임워크 범위에 관한 정량 자료는 제시하지 않았다. 따라서 ‘지원 단축’은 현재로서는 엔비디아가 설명한 구조적 효과이며, 운영 환경에서의 절감 폭은 별도 검증이 필요하다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Support New AI Frameworks Faster Using NVIDIA Workload Map | NVIDIA Technical Blog — NVIDIA Technical Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.