잠재 격자 언어 모델, 예측 성능 개선
최근 30일 조회수 — 좋아요 —핵심 요약
여러 잠재 상태를 층별로 유지하는 구조가 같은 규모의 트랜스포머보다 낮은 복잡도를 기록했다.
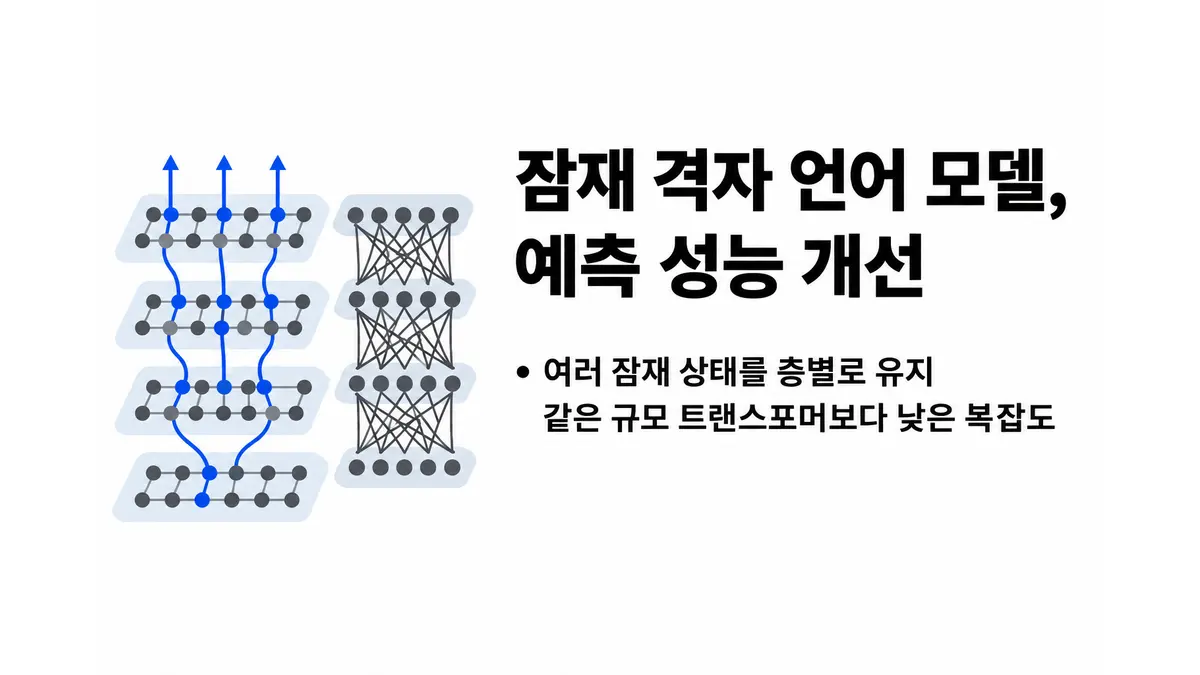
언어 모델이 토큰마다 하나의 잠재 표현만 처리하는 대신, 여러 잠재 상태를 격자처럼 유지하는 ‘잠재 격자 언어 모델(Latent Lattice Language Model)’이 제안됐다. 11월 16일 arXiv에 공개된 논문은 4억600만 매개변수 모델로 검증 복잡도(perplexity)를 같은 규모의 트랜스포머보다 15.41에서 14.40으로 낮췄다고 보고했다. 복잡도는 다음 토큰을 얼마나 잘 예측하는지 나타내는 지표로, 낮을수록 좋다.1
기존 언어 모델은 대체로 층을 더 깊게 쌓거나 같은 층을 반복하고, 잠재 추론 단계를 추가해 토큰당 연산량을 늘린다. 잔차 연결을 보강해 층 사이의 정보 흐름을 개선하는 방식도 쓰인다. 연구진이 제안한 ‘잠재 격자(Lattice of Latents)’는 연산의 깊이보다 모델이 동시에 유지하는 활성 상태의 수를 늘린다. 층을 수직으로 통과하는 기존 잔차 스트림 옆에, 각 층에서 시간축을 따라 순환하는 수평 잠재 스트림 여러 개를 배치하는 구조다.1
이 잠재 상태는 단순한 보조 메모리에 그치지 않는다. 트랜스포머와 상태공간모델(SSM)을 결합한 기존 하이브리드 구조에서는 순환 상태가 주로 시퀀스 정보를 섞는 내부 메모리 역할을 하지만, 잠재 격자는 수직 스트림의 어텐션, KV 캐시 기록, 다층 퍼셉트론(MLP) 연산과 디코딩을 직접 조절한다. 토큰이 바뀌어도 층별 잠재 상태가 이어진다는 점이 핵심이다.1
연구진은 파인웹-에듀(FineWeb-Edu) 데이터 200억 토큰으로 트랜스포머를 학습했다. 하이퍼 커넥션과 입력 잔차 연결을 적용한 트랜스포머의 복잡도는 14.22였고, 여기에 잠재 격자를 더하자 13.61로 내려갔다. 기본 트랜스포머의 15.41과 비교하면 개선 폭이 더 크다. 게이티드 델타넷(Gated DeltaNet), 맘바-2(Mamba-2), 트라이어딕 GDN(Triadic GDN)과 혼합 구조에서도 시험한 모든 고유 상태 크기에서 복잡도가 개선됐다. 잠재 격자를 적용한 GDN과 트라이어딕 GDN은 고유 상태를 네 배로 키운 순수 기준 모델보다도 나은 결과를 냈다.1
다만 이 결과는 2026년 11월 제출된 arXiv 초판 논문의 학습 실험에 근거한다. 논문이 제시하는 결론은 층별로 지속되는 상태가 모델의 연산 능력을 확장하는 별도 축이 될 수 있다는 것이며, 실제 대규모 모델이나 다양한 과제에서 같은 이점이 이어지는지는 자료에 제시되지 않았다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Latent Lattice Language Models — arXiv (cs.AI/cs.CL/cs.LG)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.